概要
製造プロセスのデジタルツインには,実プロセスを表現する物理モデル(第一原理モデル)が必要である.物理モデルの構築は,専門家が文献を調べ,数式を試行錯誤的に組み合わせる作業に依存してきた.私たちは,対象プロセスに関する文献から物理モデルを構築する人工知能(AI)システム AutoPMoB(automated physical model builder)を開発している.AutoPMoB は,対象プロセスに関する文書を検索し,変数・数式・実験データなどモデル構築に必要な情報を抽出し,文書間で情報の表記を統一したうえで,モデル候補を構築・検証・順位付けする [6].
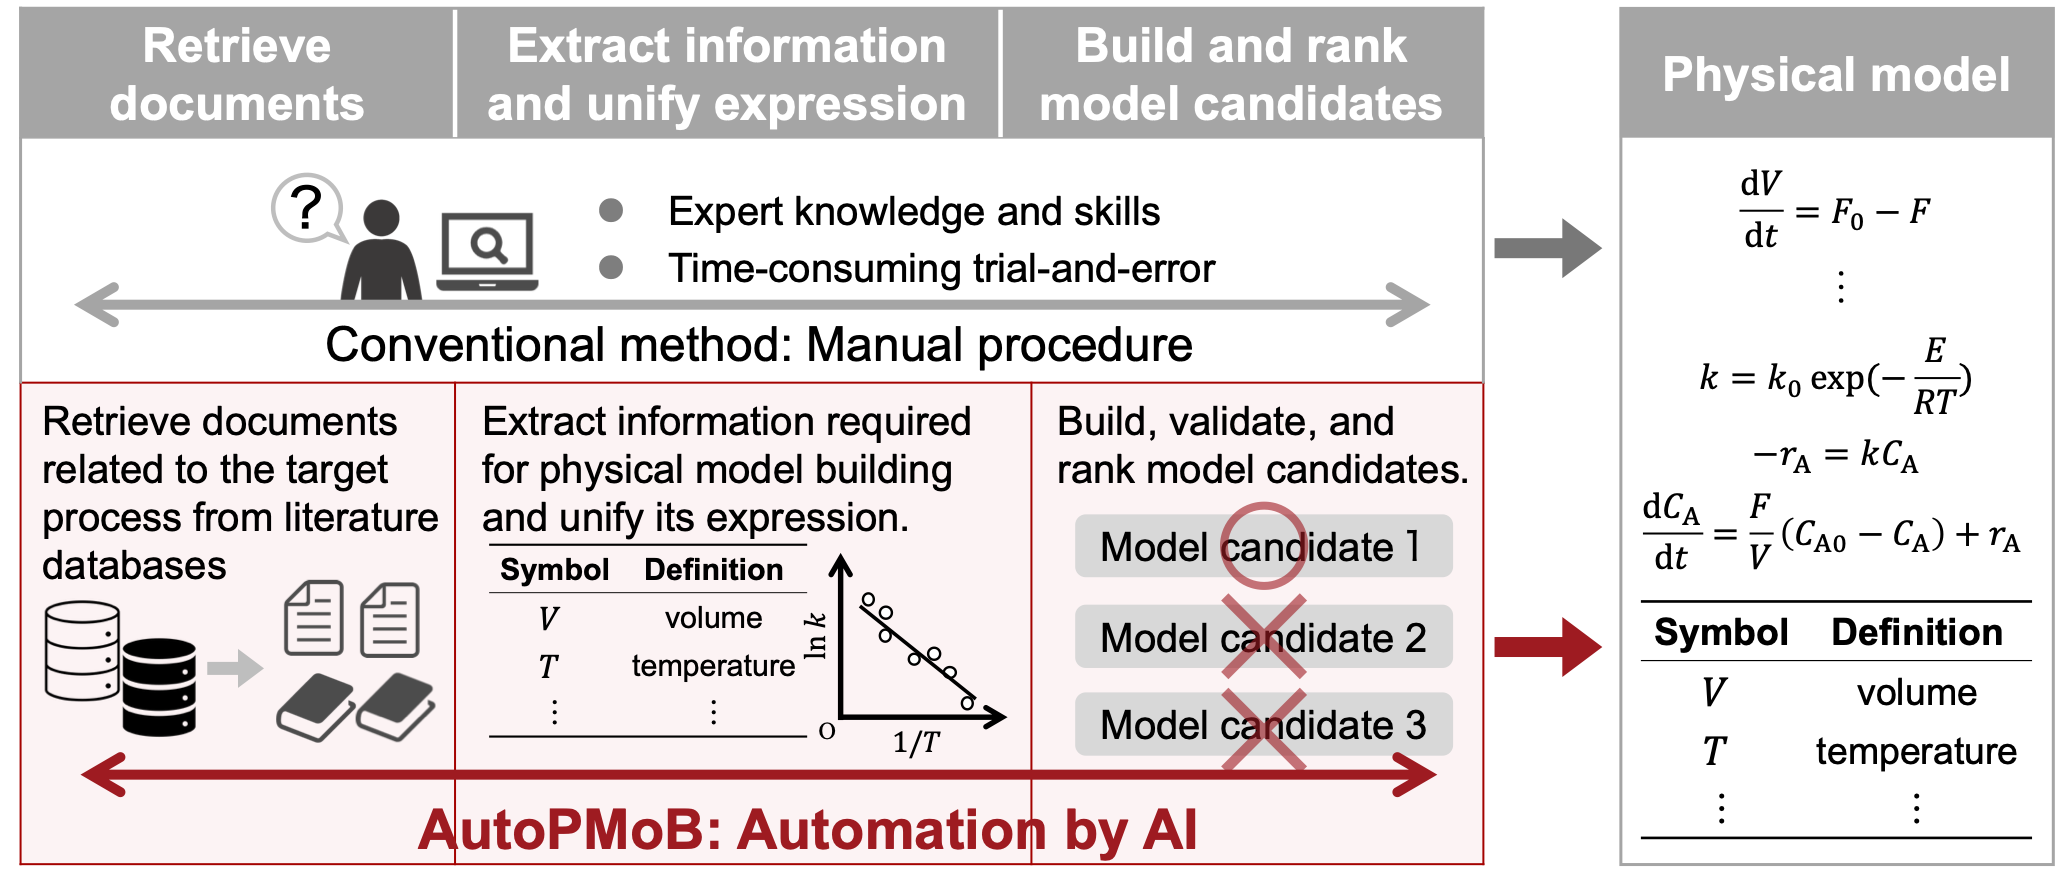
AutoPMoB の概要.S. Kato and M. Kano, Computer Aided Chemical Engineering, vol. 53, pp. 2839–2844 (2024) より転載.© 2024 Elsevier B.V.
大規模言語モデル(LLM)と私たちのモデル構築アルゴリズムを組み合わせた AutoPMoB のプロトタイプを構築し,連続槽型反応器(CSTR)に関する 9 本の論文に適用した.プロトタイプは変数定義を正解率 74.1%,再現率 95.3% で抽出し,抽出した情報から物理モデルを構築した.また,実用化に必要な課題として,文書間の表記の統一,関連文書の検索,文書以外の情報の統合を明らかにした [6].
進行中のプロジェクト
次のプロジェクトでは,AutoPMoB の対象をテキストからマルチモーダルな情報へ,モデル構築からモデル化と実験のサイクルへと拡張している.
- マルチモーダルデータを活用した自律駆動型物理モデリングの基盤構築(科学技術振興機構(JST)さきがけ,2025〜2029 年度):文献から抽出した知識と少数の実験データを統合し,抽出した知識で制約したシンボリック回帰,数式・グラフ・自然言語による説明を組み合わせたモデル評価,新しい実験条件の提案を組み合わせる.CSTR,高分子レオロジー,Czochralski 法を対象に有効性を検証する.
- 製造プロセスを理解するマルチモーダル AI による知識継承とモデル生成基盤の創出(JST BOOST,2026〜2031 年度):図面・数式・文章を統合的に理解する AI 基盤を開発する(データ解析とNLP を参照).
- 大規模言語モデルを活用した文献起点物理モデリング手法の拡張と体系化(科研費 若手研究,2026〜2029 年度)
- 自然言語・図表を用いた物理モデルの意味的評価とアクティブモデリング環境の構築(産業技術総合研究所 覚醒プロジェクト,2025〜2026 年度)
抽出した数式からのモデル構築
文献から抽出した数式には,冗長な数式,中間的な数式,互いに矛盾する数式が含まれる.私たちは,モデル構築を「四つの要件(必要な変数の包含,自由度の整合,可解性,定数を定める式の一意性)を満たす数式の組合せを選ぶ問題」として定式化した.提案した refined gradual method は,ノイズを含む数式集合や 3 成分・2 反応の CSTR を含む 8 事例すべてで正解モデルをすべて見つけた(再現率 1.00).従来の gradual method は,このうち 2 事例で正解モデルを一つも見つけられなかった.計算時間は数式集合の構造に依存し,ある事例では全探索の 14.8 秒に対して 3.94 × 10⁻⁵ 秒で終了した.最大の事例(数式 29 本,正解モデル 1,024 個)では全探索の方が速く,論文では数式集合の構造に応じた手法の選び方を示している [1].コードは GitHub で公開している.
モデル構築に必要な情報の抽出
論文から変数とその定義を抽出する手法の開発には,正解を付与したデータセット(アノテーション済みデータセット)が必要であるが,化学工学分野にはそのようなデータセットが存在しなかった.そこで,文書から変数記号を抽出し,その定義のアノテーションを支援するツール VARAT(variable annotation tool)を開発した.変数記号の抽出アルゴリズムは,5 種類の製造プロセスに関する 47 本の論文で再現率 97%,適合率 96% を達成した.VARAT を用いて 1,988 個の変数記号を含むデータセットを作成し,1 論文あたりのアノテーション時間は 1 時間以上から約 30 分に短縮された [3].
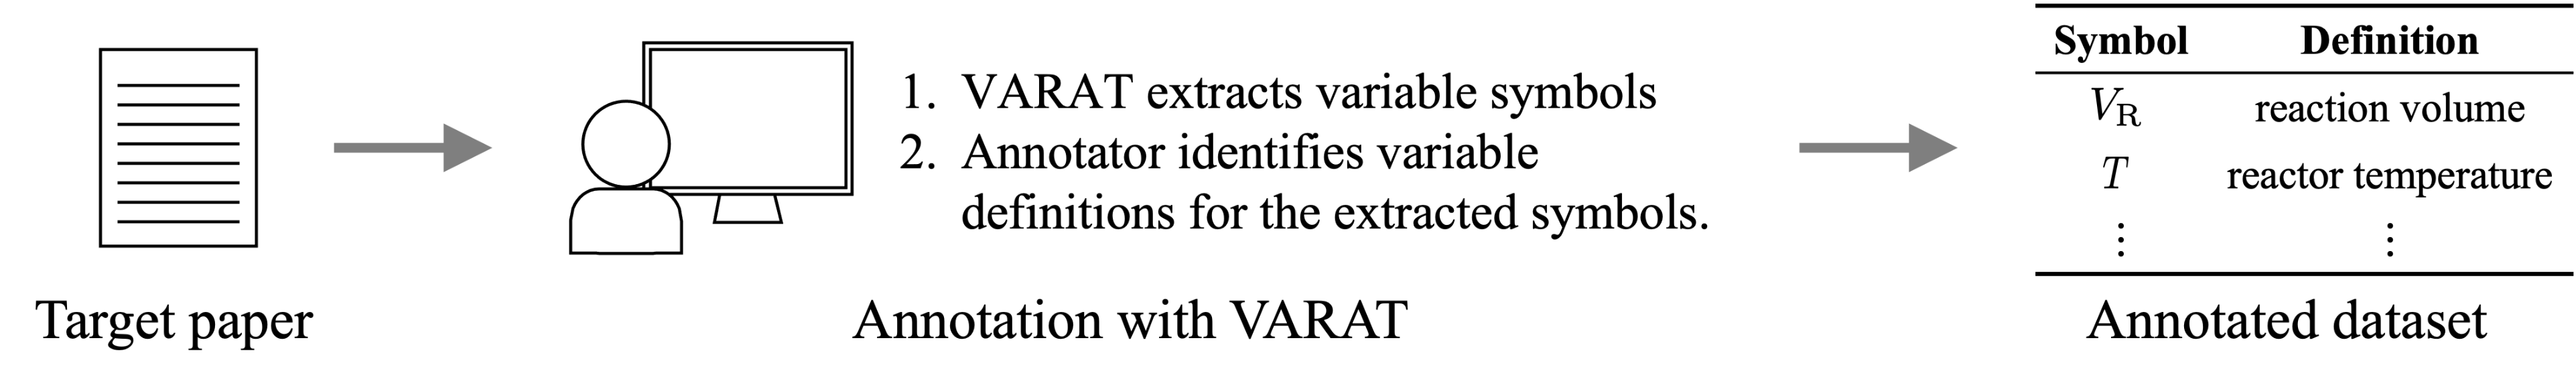
VARAT を用いたアノテーションの枠組み.S. Kato and M. Kano, Journal of Chemical Engineering of Japan, vol. 58, no. 1, 2454461 (2025) より CC BY 4.0 ライセンスに基づき転載.
このデータセットを用いて,変数定義抽出(与えられた変数記号の定義を文中から抽出するタスク)の手法を開発している.
- 二段階のファインチューニング:BERT(Bidirectional Encoder Representations from Transformers)モデルを,複数分野に共通する記述パターンで学習した後,化学プロセス関連文書で学習する.5 種類の BERT モデルのうち 4 種類で一段階のファインチューニングより性能が高く,DeBERTaV3-large は少量の学習データで正解率 85.4%,F1 スコア 84.0% を達成した [5].
- テンプレート文によるデータ拡張:変数と定義の組をテンプレート文に埋め込み,新たな学習文を生成する.生成した文で学習したモデルは正解率 88.3% を達成し,既存手法を 2.5 ポイント上回った.学習データに含まれないプロセスでも正解率が向上した [7].
抽出した情報の同義性判定
同じ変数や数式でも論文によって書き方が異なるため,AutoPMoB は抽出した二つの情報が同じものを表すか(同義性)を判定する必要がある.
- 数式群の同義性判定:二つの微分代数方程式群が同じ形に変形できるかを,数式処理システムを用いて判定するアルゴリズムを開発した.一方の数式群にのみ現れる変数を消去した後,各数式の解を一つずつ比較する.評価用の 50 組すべてを正しく判定した [2].
- 変数定義の同義性判定:化学工学分野の約 13 万本の論文で事前学習した言語モデル ProcessBERT を構築し,二つの定義の埋め込みベクトルのコサイン類似度から同義性を判定した.ProcessBERT の ROC-AUC(受信者動作特性曲線の下側面積)は 0.925 であり,BERT(0.905)と SciBERT(0.877)より高かった [4].
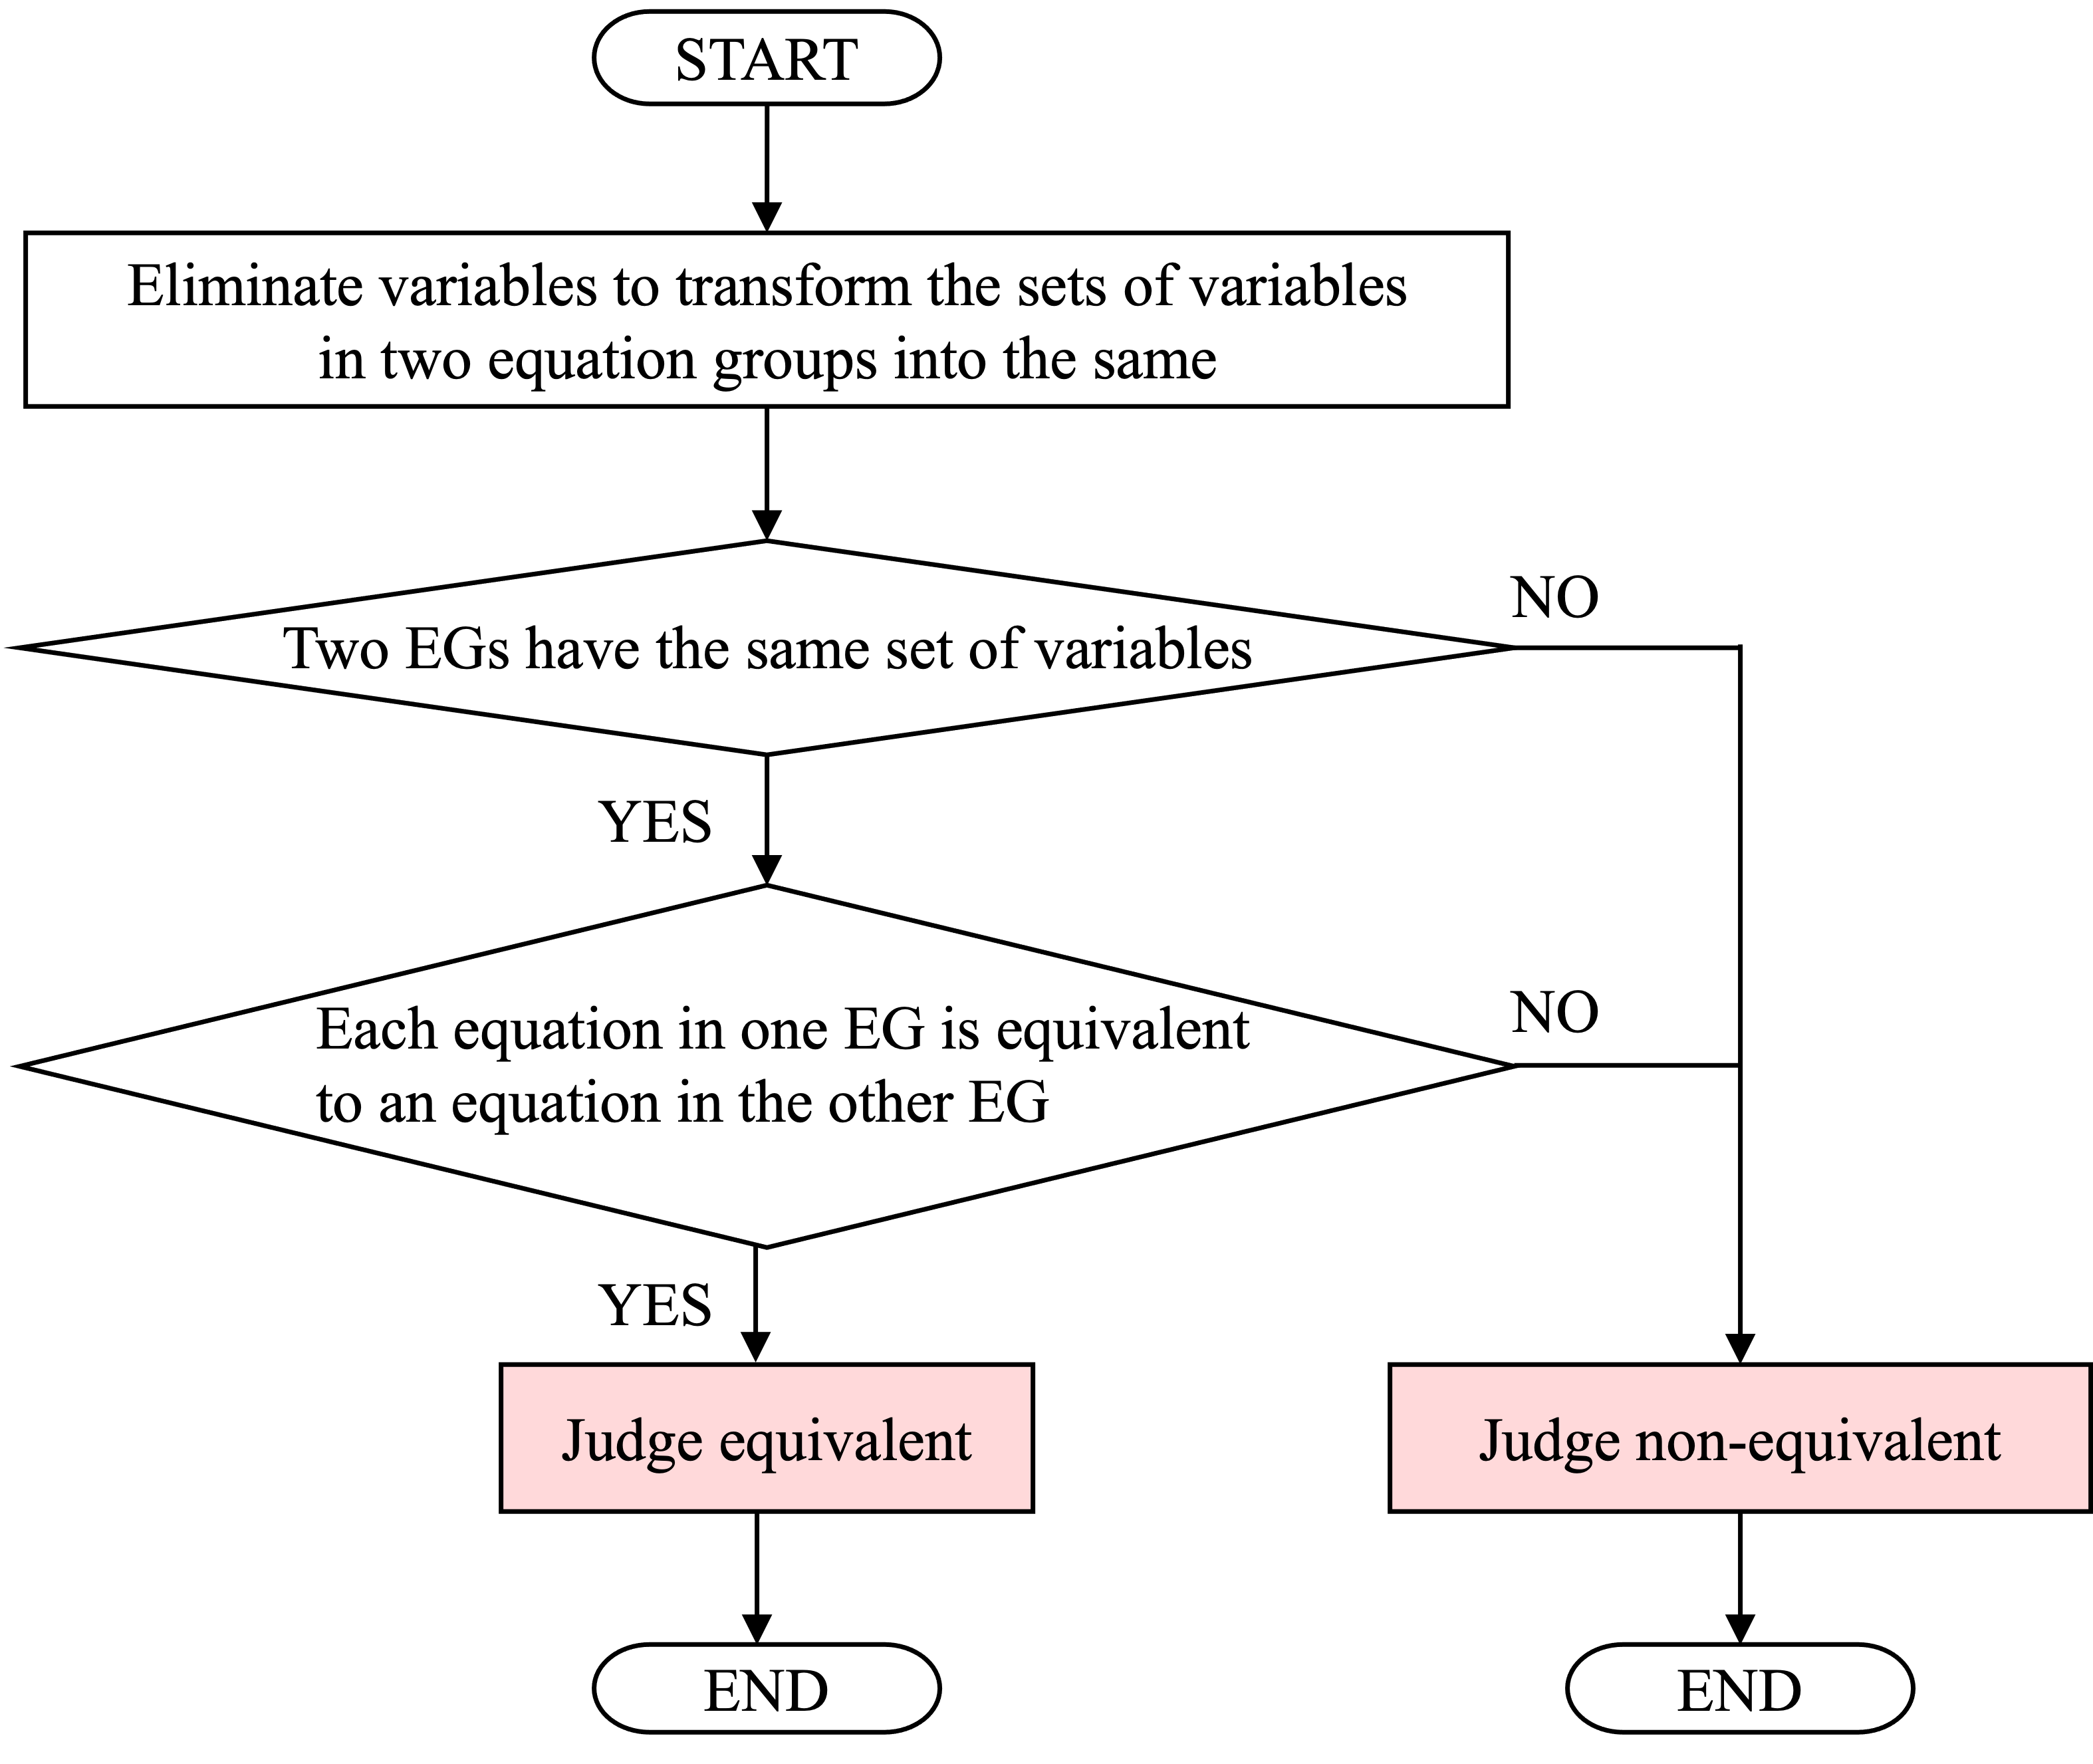
二つの数式群(EG: equation group)の同義性を判定するアルゴリズム.S. Kato, C. Zhang, and M. Kano, Scientific Reports, vol. 13, 11534 (2023) より CC BY 4.0 ライセンスに基づき転載.
参考文献
- S. Kato and M. Kano, “Automated physical model building from literature sources: Combining equations based on four predefined requirements,” Computers & Chemical Engineering, vol. 200, 109147 (2025) doi: 10.1016/j.compchemeng.2025.109147
- S. Kato, C. Zhang, and M. Kano, “Simple algorithm for judging equivalence of differential-algebraic equation systems,” Scientific Reports, vol. 13, 11534 (2023) doi: 10.1038/s41598-023-38254-y
- S. Kato and M. Kano, “VARAT: Variable Annotation Tool for Documents on Manufacturing Processes,” Journal of Chemical Engineering of Japan, vol. 58, no. 1, 2454461 (2025) doi: 10.1080/00219592.2025.2454461
- S. Kato, K. Kanegami, and M. Kano, “ProcessBERT: A Pre-trained Language Model for Judging Equivalence of Variable Definitions in Process Models,” IFAC-PapersOnLine, vol. 55, no. 7, pp. 957–962 (2022) doi: 10.1016/j.ifacol.2022.07.568
- S. Kato, M. Yamamoto, K. Nagayama, and M. Kano, “Two-Stage Fine-Tuning for Variable Definition Extraction from Chemical Process-related Papers,” DAFUSAI 2024 PDF
- S. Kato and M. Kano, “Prototype of Automated Physical Model Builder: Challenges and Opportunities,” Computer Aided Chemical Engineering, vol. 53, pp. 2839–2844 (2024) doi: 10.1016/B978-0-443-28824-1.50474-9
- K. Nagayama, S. Kato, and M. Kano, “Data Augmentation Method Utilizing Template Sentences for Variable Definition Extraction,” NLDB 2024, pp. 151–165 (2024) doi: 10.1007/978-3-031-70239-6_11
全業績は研究業績を参照.